先说一个不太受欢迎的判断:语言问题在中国作者的退稿原因里,排不到前三。
这个结论来自一个反复出现的现象——很多作者花了钱做润色,语言分明显上去了,稿子还是被拒,理由还是“not suitable”“limited novelty”“methodological concerns”。润色解决的是表达,解决不了研究本身的问题。
把退稿原因按出现频率排一遍,大致是这个顺序(基于投稿与审稿的一般经验,不是统计数据):
第六位到第一位
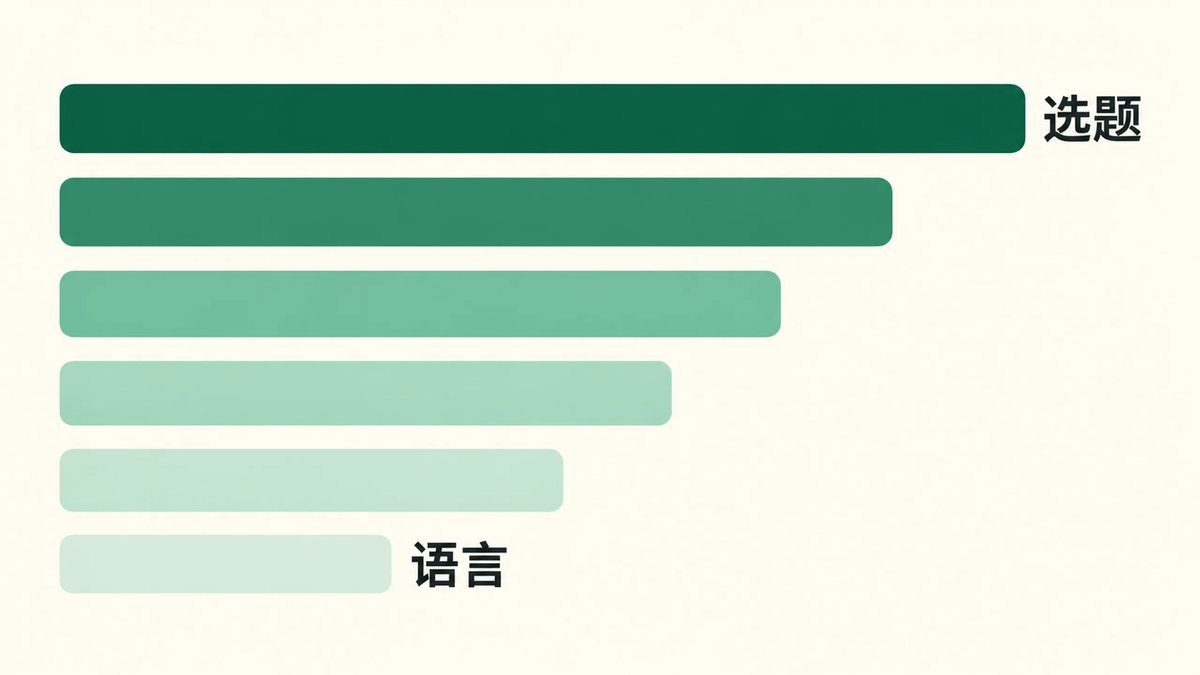
| 排位 | 原因 | 典型表现 |
|---|---|---|
| 6 | 格式与细节 | 参考文献格式乱、图分辨率不够、字数超限、缺伦理声明 |
| 5 | 语言表达 | 时态混乱、长句套叠、术语不一致、中式表达 |
| 4 | 结论越界 | 相关性被写成因果,单中心结果被写成普遍规律 |
| 3 | 统计与结果呈现 | 检验方法选错、多重比较未校正、只报 p 值不报效应量 |
| 2 | 方法描述不完整 | 别人无法复现:入排标准、测量方法、随访流程缺环节 |
| 1 | 选题与刊物范围不符 | 桌拒,编辑在 48 小时内就决定不送审 |
排第一的那条最伤,因为它决定你的稿子根本没进审稿流程。你花一个月等来的不是审稿意见,是一封格式化的拒信,什么也学不到。
第一条:不是“写得不好”,是“不该投这本”
编辑判断范围是否匹配,只看三件事:
- 这本刊近两年发过类似研究吗
- 你的研究类型在它的栏目设置里有位置吗(有的刊不收病例报告、不收纯生物信息分析)
- 你的结论层次和该刊读者的关注点对不对(基础刊不要临床疗效对比,临床刊不要纯细胞实验)
查法:下载该刊最近 4 期目录,扫一遍标题。如果 50 篇里找不到一篇和你同类,别投。这不是你的研究差,是这刊不接。
第二条:方法写不全,等于没做
这是中国作者最集中的问题,也是最容易自己发现的问题。判断标准只有一个:另一个研究者拿着你的方法部分,能不能完全重复你的研究?
常缺的六项:
- 纳入与排除标准的具体阈值(不要写“符合诊断标准”,要写哪个版本、哪一年)
- 样本量的确定依据(连续纳入?还是估算?)
- 测量方法与设备型号、参数(影像类尤其重要)
- 随访的方式与时间点(门诊?电话?失访怎么处理)
- 缺失数据的处理方式
- 统计软件与版本、具体检验方法、双侧还是单侧
第三条:统计不是“跑了就行”
审稿人看统计,主要看四个地方:
| 看什么 | 常见错误 |
|---|---|
| 检验方法与数据类型是否匹配 | 偏态数据用 t 检验;等级资料当连续变量 |
| 多重比较 | 三组两两比较未校正,假阳性被当成发现 |
| 效应量 | 只报 p 值,读者不知道差异有多大 |
| 混杂控制 | 单因素有差异的才进多因素,遗漏已知混杂 |
建议在投稿前找一位不参与本研究的统计或流行病学背景的人看一遍结果部分。自己看自己的统计,永远是“看起来没问题”。
第四条:结论越界,比数据不足更致命
常见的三句越界表述,改法很明确:
- “A 导致 B” → 回顾性研究只能写“A 与 B 独立相关”
- “可作为临床常规指标” → 单中心回顾性研究写“值得在前瞻性研究中进一步验证”
- “优于既往报道” → 除非你做了头对头比较,否则写“与既往报道方向一致”
一个简单的自查:把结论里的每一个动词圈出来,问它是不是你的数据直接支持的。“提示”“关联”“相关”是安全的,“证明”“导致”“确立”几乎总要用设计去换。
那语言什么时候真的是问题
两种情况下语言会直接决定结果:
- 影响可读性到审稿人不想读:句子长到需要读两遍才懂,审稿人会把“读不懂”记成“写得差”。
- 造成语义歧义:把“无显著差异”写成“无差异”,把“未观察到”写成“不存在”。这类不是语法错,是科学表述错。
所以润色该做的事是:把长句拆短、把时态统一、把术语统一、把含糊处说清。而不是把 simple 换成 sophisticated——用复杂词替代准确词,反而增加被质疑的空间。
投稿前 20 分钟自查
- 该刊最近 4 期有没有同类文章(第一条)
- 方法部分能不能被别人照着重复(第二条)
- 统计方法、多重比较、效应量、混杂(第三条)
- 结论里每个动词是否被数据支持(第四条)
- 通读一遍,有没有一句话需要读第二遍才懂(第五条)
- 格式、图表、声明逐条对投稿须知(第六条)
这六条里前两条决定了稿子能不能进审稿流程,后四条决定了进去之后能不能留下。语言排在第五,不是因为它不重要,是因为它前面的四条更贵。
本文排序基于投稿与审稿实践的一般观察,非统计分析结果,不同学科与期刊的实际情况会有差异。具体要求请以目标期刊投稿须知与审稿意见为准。
评论